分布式系统的相关学习
分布式系统的相关学习
W3nYui关于分布式系统的知识
分布式论文
对分布式CA特性与CAP的讨论
一个分布式的纵览博客
简单来说,分布式系统常用 CAP、BASE、PACELC 等理论描述可用性、一致性和延迟之间的取舍。
在需要多个节点就同一结果达成一致时,会使用分布式共识算法;经典代表包括 Paxos、Raft,以及 ZooKeeper 使用的 ZAB 协议。
此外,一致性哈希常用于数据分片和请求路由,以降低节点增减带来的数据迁移成本。
一致性理论主要用于描述/规定客户端能观察到什么,例如强一致性(常用线性一致性)、顺序一致性、最终一致性。
CAP理论
CAP理论:一个分布式系统最多只能同时满足 一致性(Consistency)、可用性(Availability)和分区容错性(Partition tolerance) 这三项中的两项。
CAP 定理的核心在于,在网络分区的情况下,我们需要对 C 和 A 做出相应的妥协,我们不可能完全满足 CA,但是我们可以合理控制 C 和 A 之间的比例让我们的应用/中间件正常提供服务,同时也尽量提升基础设施的稳定性来保障 P。
CAP 到底是什么
CAP 定理表达了一个分布式系统里不可能同时满足以下的三个特性:一致性、可用性、分区容错性
一致性(Consistency)
一致性是指数据能一起变化,是能让数据整齐划一。
数据何时会变化?
当且仅当包含数据的服务,收到数据更新请求的时候,数据才会发生变化。而数据更新请求则仅包括数据的增、删、改这三种请求,而这三种请求又被统称为写请求。所以,数据只有在写请求的时候才会发生变化。
数据要怎么样才能被称为一起变化了?
数据发生变化是否一致是需要经过读请求来做检验的,而不是返回写成功就一致变化了。
假设,我们的分布式存储系统有两个节点,每个节点都包含了一部分需要被变化的数据。如果经过一次写请求后,两个节点都发生了数据变化。然后,读请求把这些变化后的数据都读取到了,我们就把这次数据修改称为数据发生了一致性变化。
但这不是完整的一致性,因为系统不会永久正常的运行下去。
系统无法一致性变化?
如果系统内部发生了问题从而导致系统的节点无法发生一致性变化会怎么样呢?当我们这样做的时候,就意味着想看到最新数据的读请求们,很可能会看到旧数据,或者说获取到不同版本的数据。此时,为了保证分布式系统对外的数据一致性,于是选择不返回任何数据。
CAP与ACID的关系
这里需要注意一下,CAP 定理是在说在某种状态下的选择,和实际工程的理论是有差别的。上面描述的一致性和 ACID 事务中的一致性是两回事。事务中的一致性包含了实际工程对状态的后续处理。但是 CAP 定理并不涉及到状态的后续处理。对于工程对状态的后续处理问题,出现了BASE理论等工程结论去处理。
可用性(Availability)
可用性在 CAP 里就是对结果的要求。它要求系统内的节点们接收到了无论是写请求还是读请求,都要能处理并给回响应结果。只是它有两点必须满足的条件:
- 条件 1:返回结果必须在合理的时间以内,这个合理的时间是根据业务来定的。
- 条件 2:需要系统内能正常接收请求的所有节点都返回结果。这包含了两重含义:
- 如果节点不能正常接收请求,比如宕机了,系统崩溃了,而其他节点依然能正常接收请求,那么,我们说系统依然是可用的,也就是说允许部分节点宕机。
- 如果节点能正常接收请求,但是发现节点内部数据有问题,那么也必须返回结果,哪怕返回的结果是有问题的。比如,系统有两个节点,其中有一个节点数据是三天前的,另一个节点是两分钟前的,如果,一个读请求跑到了包含了三天前数据的那个节点上,抱歉,这个节点不能拒绝,必须返回这个三天前的数据,即使它可能不太合理。
分区容忍性(Partition tolerance)
分布式的存储系统会有很多的节点,这些节点都是通过网络进行通信。而网络是不可靠的,当节点和节点之间的通信出现了问题(可能是网络,也可能是节点硬件问题),此时就称当前的分布式存储系统出现了分区。
![[分布式分区]]
分区容忍性指的是:如果出现了分区问题,分布式存储系统还需要继续工作,而不能因为发生分区问题而停止。
CAP如何选择
在以分布式存系统为限定条件的 CAP 世界里,P 是早已经确定的答案,P 是必须的。因为,在分布式系统内,P 是必然的发生的,不选 P,一旦发生分区错误,整个分布式系统就完全无法使用了,这是不符合实际需要的。所以,对于分布式系统,我们只能考虑当发生分区错误时,如何选择一致性和可用性。
CP 系统
而根据一致性和可用性的选择不同,开源的分布式系统往往又被分为 CP 系统和 AP 系统。
当一套系统在发生分区故障后,客户端的任何请求都被卡死或者超时,但是,系统的每个节点总是会返回一致的数据,则这套系统就是 CP 系统,经典的比如 Zookeeper。
AP 系统
如果一套系统发生分区故障后,客户端依然可以访问系统,但是获取的数据有的是新的数据,有的还是老数据,那么这套系统就是 AP 系统,经典的比如 Eureka。
常见误区
1. 分布式系统只有CP与AP
P 这种问题发生的概率非常低,所以:
当没有出现分区问题的时候,系统就应该有完美的数据一致性和可用性。
2. C 和 A 之间的选择是针对整个分布式系统的,只能整体考虑 C 和 A 之间的选择
当分区发生的时候,其实对一致性和可用性的抉择是局部性的,而不是针对整个系统的。
可能是在一些子系统做一些抉择,甚至很可能只需要对某个事件或者数据,做一致性和可用性的抉择而已。
比如,当做一套支付系统的时候,会员的财务相关像账户余额,账务流水是必须强一致性的。这时候,你就要考虑选 C。但是,会员的名字,会员的支付设置就不必考虑强一致性,可以选择可用性 A。
3. CAP 的三个特性只有是和否两种极端选择
CAP 理论的三种特性不是 Boolean 类型的,不是一致和不一致,可用和不可用,分区和没分区的这类二选一的选项。而是这三种特性都是范围类型。具体可以看2017年作者的论文,详细描述了对他本人对提出CAP后的想法。
比如,分区容错则由于探测机制的问题,可能需要各节点投票来协商分区是否存在,当某一台机器出现了问题,可能不影响业务的话,就会被机器投票认为分区不存在。然后一直等到多数机器出现了问题,才会投票确认出现了分区问题。
CAP的不足
- CAP 定理本身是没有考虑网络延迟的问题的,它认为一致性是立即生效的,但是,要保持一致性,是需要时间成本的,这就导致往往分布式系统多选择 AP 方式
- 由于时代的演变,CAP 定理在针对所有分布式系统的时候,出现了一些力不从心的情况,导致很多时候它自己会把以前很严谨的数学定义改成了比较松弛的业务定义,类似于我们看到,CAP 定理把一致性、可用性、分区容错都变成了一个范围属性,而这和 CAP 定理本身这种数学定理般的称呼是有冲突的,出现了不符合数学严谨定义的问题。
- 在实践中以及后来 CAP 定理的提出者也承认,一致性和可用性并不仅仅是二选一的问题,只是一些重要性的区别,当强调一致性的时候,并不表示可用性是完全不可用的状态。比如,Zookeeper 只是在 master 出现问题的时候,才可能出现几十秒的不可用状态,而别的时候,都会以各种方式保证系统的可用性。而强调可用性的时候,也往往会采用一些技术手段,去保证数据最终是一致的。CAP 定理并没有给出这些情况的具体描述。
- CAP 理论从工程角度来看只是一种状态的描述,它告诉大家当有错的时候,分布式系统可能处在什么状态。但是,状态是可能变化的。状态间如何转换,如何修补,如何恢复是没有提供方向的。
总结
CAP 就是告诉程序员们当分布式系统出现内部问题了,你要做两种选择:
- 要么迁就外部服务,像外包公司。
- 要么让外部服务迁就你,像银行。
CAP理论的完善 – PACELC理论
2010年,耶鲁大学教授丹尼尔·阿巴迪提出PACELC理论,扩展了CAP定理。原有的CAP定理重写为PAC,ELC则代表“Else, choose between (low) latency and consistency”。即在网络正常(没有分区)的情况下,须选择低延迟或一致性。
根据PACELC理论,分布式系统可分为四种不同的运作模式:P + A/C + IF(NO P) Choose L/C
- PA/EL: 相比数据一致性,优先选择可用性和低延迟
- PA/EC: 出现分区时选择可用性,无分区时选择一致性
- PC/EL: 出现分区时选择一致性,无分区时选择低延迟
- PC/EC: 任何时候,以保持数据一致性为优先

设计师可以自行设定数据库管理系统的运作模式。
例如,一个系统包含两份数据,可读写的主数据库和只读的副数据库。如果副数据库与主数据库同步,则系统属于EC。如果副数据库异步,但允许读取,则系统属于EL。如果副数据库不适合设定为同步备份,设计师可禁用读取功能,让用户只读取主数据库,此时系统为EC。
CAP的工程权衡 – BASE理论
BASE理论是分布式系统设计原则,由eBay架构师Dan Pritchett于2008年在ACM发表的文章中提出,作为对CAP定理中一致性与可用性权衡的延伸应用。
该理论包含如下三点,旨在通过放宽强一致性要求实现高可用性。
- 基本可用(Basically Available)
- 软状态(Soft State)
- 最终一致性(Eventually Consistent)
Basically Available(基本可用)
基本可用是指:分布式系统在出现不可预知故障的时候,允许损失部分可用性。例如:
- 响应时间上的损失。正常情况下,0.5秒之内返回给用户结果,但由于出现故障,会有重试等操作,3秒内返回也可以接受。
- 系统功能上的损失:正常情况下,用户可以顺利完成每一笔订单,但是在一些流量高峰的时候,为了保护系统的稳定性,部分用户可能会被引导到一个降级页面。
Basically Available(基本可用)没有 CAP 中的可用性定义那么严格(在一定时间内可以得到正确的响应)。
Soft state(软状态)
软状态是指:允许系统中的数据存在中间状态,这种中间状态的存在不会影响数据的整体一致性。
例如:在 A 账户向 B 账户交易100的场景中,因为不会很快交易完成或者存在交易失败的情况,所以不会直接扣减 A 账户的100到 B 账户上,而是先把 A 账户的可用额度扣减到冻结额度上。
这样的话,即使在交易进行中,也不会影响 A 账户的使用(如果 A 账户可用余额足够,依然可以继续交易)。
软状态是相对原子性来说的:
- 原子性(硬状态):要求多个节点的数据副本都是一致的,这是一种”硬状态”。
- 软状态(弱状态):允许系统中的数据存在中间状态,并认为该状态不影响系统的整体可用性,即允许系统在多个不同节点的数据副本存在数据延迟。
Eventually consistent(最终一致性)
最终一致性是指:在经过一段时间后,软状态的数据达到最终一致的状态。
例如:在冻结 A 账户100后,如果失败那就扣减A账户冻结的100至可用余额中。如果交易成功将 A 账户冻结的100扣减,并添加至 B 账户的可用余额。最终达到一致性。
- 系统并不保证连续进程或者线程的访问都会返回最新的更新过的值。系统在数据写入成功之后,不承诺立即可以读到最新写入的值,也不会具体的承诺多久之后可以读到。但会尽可能保证在某个时间级别(比如秒级别)之后,可以让数据达到一致性状态。最终一致性是弱一致性的特定形式。
- 对于软状态,我们允许中间状态存在,但不可能一直是中间状态,必须要有个期限,系统保证在没有后续更新的前提下,在这个期限后,系统最终返回上一次更新操作的值,从而达到数据的最终一致性,这个容忍期限(不一致窗口的时间)取决于通信延迟,系统负载,数据复制方案设计,复制副本个数等。DNS 就是一个典型的最终一致性系统。
实现强一致的复制状态机 – Raft
Raft 是一个容忍崩溃故障(crash/fail-stop)的分布式共识算法;它让多数副本就一条有序日志达成一致,并可据此构建线性一致的复制状态机。
Raft 解决的问题:多台机器共同保存一个关键状态时,谁是主、写入按什么顺序发生、主机故障后谁接班、已确认的数据会不会丢。
在CAP中,它偏向CP,为了一致性牺牲了部分可用性,在PACELC中,他偏向PC/EC,在写入时需要等待多数副本确认,利用延迟换取了一致性。
和BASE比起来,Raft目的是获取强一致性的协议,而BASE在可用性与一致性间选了权衡。
引用文章
Raft算法介绍
一致性模型与共识算法
百度的C++Raft开源项目
什么是共识算法
共识算法允许一组节点像一个整体一样一起工作,即使其中一些节点出现故障也能够继续工作下去,其正确性主要源于复制状态机的性质:
任何初始状态一样的状态机,如果执行的命令序列一样,则最终达到的状态也一样。如果将此特性应用在多参与者进行协商共识上,可以理解为系统中存在多个具有完全相同的状态机(参与者),这些状态机能最终保持一致的关键就是起始状态完全一致和执行命令序列完全一致。
共识算法常被用来确保每一个节点上的状态机一定都会按相同的顺序执行相同的命令, 并且最终会处于相同的状态。换句话说,可以理解为共识算法就是用来确保每个节点上的日志顺序都是一致的。(不过需要注意的是,只确保“提交给状态机的日志”顺序是一致的,而有些日志项可能只是暂时添加,尚未决定要提交给状态机)。正因为如此,共识算法在构建可容错的大规模分布式系统中扮演着重要的角色。

当然,实际使用系统中的共识算法一般满足以下特性:
- 在非拜占庭条件下保证共识的一致性。(非拜占庭条件,指的就是每一个节点都是诚实可信的,每一次信息的传递都是真实的且符合协议要求的,当节点无法满足协议所要求的条件时,就停止服务,节点仅会因为网络延迟或崩溃出现不一致,而不会有节点传递错误的数据或故意捏造假数据。)
- 在多数节点存活时,保持可用性。(“多数”永远指的是配置文件中所有节点的多数,而不是存活节点的多数。)
- 不依赖于时间,错误的时钟和高延迟只会导致可用性问题,而不会导致一致性问题。
- 在多数节点一致后就返回结果,而不会受到个别慢节点的影响。
Raft概述
Raft的节点类型
Raft 将所有节点分为三个身份:
Leader:集群内最多只会有一个 leader,负责发起心跳,响应客户端,创建日志,同步日志。Candidate:leader 选举过程中的临时角色,由 follower 转化而来,发起投票参与竞选。Follower:接受 leader 的心跳和日志同步数据,投票给 candidate。
上图展示了Raft节点的变迁条件,整体变迁条件如下:
| 当前状态 | 触发条件 | 新状态 | 含义 |
|---|---|---|---|
| 启动 | 节点刚启动 | Follower | 所有节点默认以跟随者开始。 |
| Follower | 选举超时,未收到 Leader 心跳/日志复制 | Candidate | 任期 term 加一,给自己投票,并向另外两台请求选票。 |
| Candidate | 获得多数票(至少 2 票) | Leader | 成为主节点,立刻发送心跳,维持领导权。 |
| Candidate | 选举再次超时,仍未获多数 | Candidate | 开启新一轮选举:任期再加一,重新投票。 |
| Candidate | 收到当前任期 Leader 的有效心跳,或发现更高任期 | Follower | 放弃竞选,承认已有合法 Leader。 |
| Leader | 收到包含更高 term 的 RPC/消息 |
Follower | 说明集群已有更新的任期,旧 Leader 立即退位。 |
节点状态
每一个节点都应该有的持久化状态:
currentTerm:当前任期,保证重启后任期不丢失。votedFor:在当前 term,给哪个节点投了票,值为 null 或candidate id。即使节点重启,Raft 算法也能保证每个任期最多只有一个 leader。log[]:已经 committed 的日志,保证状态机可恢复。
每一个节点都应该有的非持久化状态:
commitindex:已提交的最大 index。leader 节点重启后可以通过 appendEntries rpc 逐渐得到不同节点的 matchIndex,从而确认 commitIndex,follower 只需等待 leader 传递过来的 commitIndex 即可。lastApplied:已被状态机应用的最大 index。raft 算法假设了状态机本身是易失的,所以重启后状态机的状态可以通过 log[] (部分 log 可以压缩为 snapshot) 来恢复。
leader 的非持久化状态:
nextindex[]:为每一个 follower 保存的,应该发送的下一份entry index;初始化为本地 last index + 1。matchindex[]:已确认的,已经同步到每一个 follower 的entry index。初始化为 0,根据复制状态不断递增,
(注:每次选举后,leader 的此两个数组都应该立刻重新初始化并开始探测)
身份任期问题

如图所示,Raft 将时间划分成为任意不同长度的 term。term 用连续的数字进行表示。每一个 term 的开始都是一次选举,一个或多个 candidate 会试图成为 leader。如果一个 candidate 赢得了选举,它就会在该 term 担任 leader。在某些情况下,选票会被均分,即 split vote(例如总数为偶数节点时两个 candidate 节点各获得了两票),此时无法选出该 term 的 leader,那么在该 term 的选举超时后将会开始另一个 term 的选举。
不同的服务器节点可能多次观察到 term 之间的转换,但在某些情况下,一个节点也可能观察不到任何一次选举或者整个 term 全程。term 在 Raft 算法中充当逻辑时钟(类似于 Lamport timestamp)的作用,这会允许服务器节点查明一些过期的信息比如过期的 leader。
每个节点都会存储当前 term 号,这一编号在整个时间内单调增长。当服务器之间通信的时候会交换当前 term 号;如果一个服务器的当前 term 号比其他人小,那么他会更新自己的 term 到较大的 term 值。如果一个 candidate 或者 leader 发现自己的 term 过期了,那么他会立即退回 follower。如果一个节点接收到一个包含过期 term 号的请求,那么它会拒绝或忽略这个请求。这实际上就是一个 Lamport 逻辑时钟的具体实现。
那么该如何立即这个term,在整个算法流程中他代表了什么?
一次 term 的核心问题是:这一轮能不能选出一个合法 Leader?
超时不必然意味着所有节点都要变更身份:
- Follower 的选举超时:它创建一个新 term,并变为 Candidate。
- Candidate 的选举超时:说明本轮没选出 Leader,它进入更大的 term,继续当 Candidate 再选一次。
- Leader 通常没有“选举超时”;只要它正常发送心跳、未发现更高 term,就一直是 Leader。
- Follower 收到合法 Leader 心跳:保持 Follower,只重置自己的选举计时器。
- Candidate 收到同 term 的合法 Leader 心跳:变回 Follower,但 term 可以不变。
- 任意节点发现更高 term:更新 term;若原来是 Candidate/Leader,则变为 Follower(退化)。
例如,term 8中 A 当选 Leader 后,B、C 并不会因为时间经过而换身份;它们维持Follower,A 维持Leader。只有 A 的心跳无法送达、某个 Follower 超时,才会触发term 9的新选举。
日志
entry:Raft 中,将每一个事件都称为一个 entry,每一个 entry 都有一个表明它在 log 中位置的 index(之所以从 1 开始是为了方便prevLogIndex从 0 开始)。只有 leader 可以创建 entry。entry 的内容为<term, index, cmd>,其中 cmd 是可以应用到状态机的操作。在 raft 组大部分节点都接收这条 entry 后,entry 可以被称为是 committed 的。log:由 entry 构成的数组,只有 leader 可以改变其他节点的 log。 entry 总是先被 leader 添加进本地的 log 数组中去,然后才发起共识请求,获得 quorum 同意后才会被 leader 提交给状态机。follower 只能从 leader 获取新日志和当前的 commitIndex,然后应用对应的 entry 到自己的状态机。
保证
Election Safety:每个 term 最多只会有一个 leader;集群同时最多只会有一个可以读写的 leader。Leader Append-Only:leader 的日志是只增的。Log Matching:如果两个节点的日志中有两个 entry 有相同的 index 和 term,那么它们就是相同的 entry。Leader Completeness:一旦一个操作被提交了,那么在之后的 term 中,该操作都会存在于日志中。State Machine Safety:一致性,一旦一个节点应用了某个 index 的 entry 到状态机,那么其他所有节点应用的该 index 的操作都是一致的。
领导人选举问题
Raft 使用心跳来维持 leader 身份。任何节点都以 follower 的身份启动。 leader 会定期的发送心跳给所有的 follower 以确保自己的身份。 每当 follower 收到心跳后,就刷新自己的 electionElapsed,重新计时。
(后文中,会将预设的选举超时称为 electionTimeout,而将当前经过的选举耗时称为 electionElapsed)。
一旦一个 follower 在指定的时间内没有收到任何 RPC(称为 electionTimeout),则会发起一次选举(主动发起)。 当 follower 试图发起选举后,其身份转变为 candidate,在增加自己的 term 后, 会向所有节点发起 RequestVoteRPC 请求,candidate 的状态会一直持续直到:
- 赢得选举
- 其他节点赢得选举
- 一轮选举结束,无人胜出
选举的方式非常简单,谁能获取到多数选票 (N/2 + 1),谁就成为 leader(这里的N指的是所有节点数量,而不是存活节点数量)。 在一个 candidate 节点等待投票响应的时候,它有可能会收到其他节点声明自己是 leader 的心跳, 此时有两种情况:
- 该请求的 term 和自己一样或更大:说明对方已经成为 leader,自己立刻退为 follower。
- 该请求的 term 小于自己:拒绝请求并返回当前 term 以让请求节点更新 term。
为了防止在同一时间有太多的 follower 转变为 candidate 导致无法选出绝对多数, Raft 采用了随机选举超时(randomized election timeouts)的机制, 每一个 candidate 在发起选举后,都会随机化一个新的选举超时时间, 一旦超时后仍然没有完成选举,则增加自己的 term,然后发起新一轮选举。 在这种情况下,应该能在较短的时间内确认出 leader。 (因为 term 较大的有更大的概率压倒其他节点)
etcd 中将随机选举超时设置为 [electiontimeout, 2 * electiontimeout - 1]。
通过一个节点在一个 term 只能给一个节点投票,Raft 保证了对于给定的一个 term 最多只有一个 leader,从而避免了选举导致的 split brain(脑裂) 以确保 safety;通过不同节点每次随机化选举超时时间,Raft 在实践中(注意:并没有在理论上)避免了活锁以确保 liveness。
日志同步问题
leader 被选举后,则负责所有的客户端请求。每一个客户端请求都包含一个命令,该命令可以被作用到 RSM。
leader 收到客户端请求后,会生成一个 entry,包含 <index, term, cmd>,再将这个 entry 添加到自己的日志末尾后,向所有的节点广播该 entry。
follower 如果同意接受该 entry,则在将 entry 添加到自己的日志后,返回同意。
如果 leader 收到了多数的成功答复,则将该 entry 应用到自己的 RSM, 之后可以称该 entry 是 committed 的。该 committed 信息会随着随后的 AppendEntries 或 Heartbeat RPC 被传达到其他节点。

Raft 保证下列两个性质:
- 如果在两个日志(节点)里,有两个 entry 拥有相同的 index 和 term,那么它们一定有相同的 cmd;
- 如果在两个日志(节点)里,有两个 entry 拥有相同的 index 和 term,那么它们前面的 entry 也一定相同。
通过”仅有 leader 可以生成 entry”来确保第一个性质, 第二个性质则通过一致性检查(consistency check)来保证,该检查包含几个步骤:
leader 在通过 AppendEntriesRPC 和 follower 通讯时,会带上上一块 entry 的信息, 而 follower 在收到后会对比自己的日志,如果发现这个 entry 的信息(index、term)和自己日志内的不符合,则会拒绝该请求。一旦 leader 发现有 follower 拒绝了请求,则会与该 follower 再进行一轮一致性检查, 找到双方最大的共识点,然后用 leader 的 entries 记录覆盖 follower 所有在最大共识点之后的数据。
寻找共识点时,leader 还是通过 AppendEntriesRPC 和 follower 进行一致性检查, 方法是发送再上一块的 entry, 如果 follower 依然拒绝,则 leader 再尝试发送更前面的一块,直到找到双方的共识点。 因为分歧发生的概率较低,而且一般很快能够得到纠正,所以这里的逐块确认一般不会造成性能问题。当然,在这里进行二分查找或者某些规则的查找可能也能够在理论上得到收益。
Leader 会为每个 Follower 分别维护 nextIndex 和 matchIndex 两个变量。nextIndex 表示下一次准备发送给该 Follower 的日志起始位置;matchIndex 表示 Leader 已确认该 Follower 成功复制的最大日志索引。Leader 刚当选时,通常将所有 Follower 的 nextIndex 初始化为自身最后一条日志索引加一,暂时假设它们都已同步完成。
Leader 通过 AppendEntries RPC 复制日志时,会携带待追加位置之前的日志索引和任期,用于进行一致性检查。若 Follower 发现该前置日志与本地日志不一致,就会拒绝请求。Leader 收到拒绝后,会减小该 Follower 的 nextIndex,并使用更早的日志位置再次发起同步;实际实现中也可以利用 Follower 返回的冲突信息跳过多次回退。直到双方找到最后一个日志内容一致的位置后,Leader 再从该位置之后向 Follower 发送日志。Follower 会删除与 Leader 冲突的旧日志后缀,并追加 Leader 提供的正确日志。
当 Follower 成功接收日志后,Leader 将 matchIndex 更新为本次已成功匹配的最大日志索引,并将 nextIndex 更新为 matchIndex + 1。日志落后时可以批量发送多条日志以提高同步效率;寻找共同日志点时则可以少量发送,避免传输无效数据。
综上所述,整体日志流程如下:
一条客户端命令的流程是:
1 | 客户端请求 |
同步时,Leader 发送 AppendEntries 会带上“准备追加的位置之前的那条日志”,在Follower接收到后,Follower 先检查自己的 (prevLogIndex, prevLogTerm) 是否与 Leader 一致:
- 一致:说明此前日志相同,可以追加新日志;
- 不一致:拒绝这次请求;
- Leader 收到拒绝后,向前移动这个 Follower 的
nextIndex,再试更早的位置; - 找到最后一个共同位置后,Leader 删除/覆盖该 Follower 从冲突点开始的旧日志,再把自己的正确日志补过去。
因此最终保证:
两个节点若某个位置的
index和term相同,则该日志项及其之前的所有日志都相同。
更重要的是:Leader 并不是“只要某条日志被多数复制就一律提交”。严格来说,它会直接提交当前 term 创建且已复制到多数的日志;更早 term 的日志会随着后续当前 term 日志的提交而被间接确认。这条规则用于避免旧 Leader 的未提交日志在换主后被错误提交。
安全问题
选举限制
因为 leader 的强势地位,所以 Raft 在投票阶段就确保选举出的 leader 一定包含了整个集群中目前已 committed 的所有日志。
当 candidate 发送 RequestVoteRPC 时,会带上最后一个 entry 的信息。 所有的节点收到该请求后,都会比对自己的日志,如果发现自己的日志更新一些,则会拒绝投票给该 candidate。 (Pre-Vote 同理,如果 follower 认为 Pre-Candidate 没有资格的话,会拒绝 PreVote)
判断日志新旧的方式:获取请求的 entry 后,比对自己日志中的最后一个 entry。 首先比对 term,如果自己的 term 更大,则拒绝请求。 如果 term 一样,则比对 index,如果自己的 index 更大(说明自己的日志更长),则拒绝请求。

在上图中,raft 为了避免出现一致性问题,要求 leader 绝不会提交过去的 term 的 entry (即使该 entry 已经被复制到了多数节点上)。leader 永远只提交当前 term 的 entry, 过去的 entry 只会随着当前的 entry 被一并提交。(上图中的 c,term2 只会跟随 term4 被提交。)
如果一个 candidate 能取得多数同意,说明它的日志已经是多数节点中最完备的, 那么也就可以认为该 candidate 已经包含了整个集群的所有 committed entries。
因此 leader 当选后,应当立刻发起 AppendEntriesRPC 提交一个 no-op entry。注意,这是一个 Must,不是一个 Should,否则会有许多 corner case 存在问题。比如:
- 读请求情况下:
- 新 leader 不知道旧日志到底哪些已提交。若立刻从状态机读,状态机可能尚未应用本应生效的旧日志,返回过期结果,破坏线性一致性。
- 若“不确定就不读”,而此后没有任何写请求,新 leader 就一直没有机会提交当前任期日志,读请求会一直等待,产生 liveness 问题。
- 配置变更情况下:
- 旧任期的成员变更日志无法被推进为提交,集群仍必须按旧配置投票;被移除节点仍可能有投票权,新节点尚不能成为正式投票成员。
- Raft 通常禁止同时进行多个配置变更。前一个旧任期配置变更未提交,会使重配置长期卡住。
实际上,leader 当选后提交一个 no-op entry 日志的做法就是 Raft 算法解决 “幽灵复现” 问题的解法。因此遗留日志最终只有两种合法命运:
- 新 leader 的日志不包含它:它作为未提交日志被覆盖、消失;
- 新 leader 包含它:通过提交当前任期
no-op,它被正式提交、不可再消失。
节点崩溃恢复
如果 leader 崩溃,集群中的所有节点在 electionTimeout 时间内没有收到 leader 的心跳信息就会触发新一轮的选主。总而言之,最终集群总会选出唯一的 leader 。按论文中的说法,计算一次 RPC 耗时高达 30~40ms 时,99.9% 的选举依然可以在 3s 内完成,但一般一个机房内一次 RPC 只需 1ms。当然,选主期间整个集群对外是不可用的。
如果 follower 和 candidate 奔溃相对而言就简单很多, 因为 Raft 所有的 RPC 都是幂等的,所以 Raft 中所有的请求,只要超时,就会无限的重试。follower 和 candidate 崩溃恢复后,可以收到新的请求,然后按照上面谈论过的追加或拒绝 entry 的方式处理请求。
时间与可用性
Raft 原则上可以在绝大部分延迟情况下保证一致性, 不过为了保证选择和 leader 的正常工作,最好能满足下列时间条件:
1 | broadcastTime << electionTimeout << MTBF |
broadcastTime:向其他节点并发 发送消息的平均响应时间;electionTimeout:follower 判定 leader 已经故障的时间(心跳包 的最长容忍间隔);MTBF(mean time between failures):单台机器的平均健康时间;
一般来说,broadcastTime 一般为 0.5~20ms,electionTimeout 可以设置为 10~500ms,MTBF 一般为一两个月。
日志压缩问题
Raft 的日志在正常运行期间会增长以合并更多的客户请求,但是在实际的系统中,Raft 的日志无法不受限制地增长。随着日志的增长,日志会占用更多空间,并且需要花费更多时间进行重放。如果没有某种机制可以丢弃日志中累积的过时信息,这最终将导致可用性问题。因此需要定时去做 snapshot。
snapshot 会包括:
- 状态机当前的状态。
- 状态机最后一条应用的 entry 对应的 index 和 term。
- 集群最新配置信息。
- 为了保证 exactly-once 线性化语义的去重表。
各个节点自行择机完成自己的 snapshot 即可,如果 leader 发现需要发给某一个 follower 的 nextIndex 已经被做成了 snapshot,则需要将 snapshot 发送给该 follower。注意 follower 拿到非过期的 snapshot 之后直接覆盖本地所有状态即可,不需要留有部分 entry,也不会出现 snapshot 之后还存在有效的 entry。因此 follower 只需要判断 InstallSnapshot RPC 是否过期即可。过期则直接丢弃,否则直接替换全部状态即可。
snapshot 可能会带来两个问题:
- 做 snapshot 的策略?
一般为定时或者定大小,达到阈值即做 snapshot,做完后对状态机和 raft log 进行原子性替换即可。 - 做 snapshot 时是否还可继续提供写请求?
一般情况下,做 snapshot 期间需要保证状态机不发生变化,也就是需要保证 snapshot 期间状态机不处理写请求。当然 raft 层依然可以去同步,只是状态机不能变化,即不能 apply 新提交的日志到状态机中而已。要想做的更好,可以对状态机采用copy-on-write的复制来不阻塞写请求。
禅让问题
有时候,会希望取消当前 leader 的管理权,比如:
- leader 节点因为运维原因需要重启;
- 有其他更适合当 leader 的节点;
直接将 leader 节点停机的话,其他节点会等待 electionTimeout 后进入选举状态, 这期间会集群会停止响应。为了避免这一段不可用的时间,可以采用禅让机制(leadership transfer)。
禅让的步骤为:
- leader 停止响应客户端请求;
- leader 向 target 节点发起一次日志同步;
- leader 向 target 发起一次 TimeoutNowRPC,target 收到该请求后立刻发起一轮投票。
etcd 中实现了更多的细节(也有一些改动):
- leader 先检查禅让对象(leadTransferee)的身份,如果是 follower,直接忽略;
- leader 检查是否有正在进行的禅让,如果有,则中止之前的禅让状态,开始处理最新的请求;
- 检查禅让对象是否是自己,如果是,忽略;
- 将禅让状态信息计入 leader 的状态,并且重置 electionElapsed(因为禅让应该在 electionTimeout 内完成);
- 检查禅让对象的日志是否是最新的
- 如果禅让对象已经是最新,则直接发送 TimeoutNowRPC
- 如果不是,则发送 AppendEntriesRPC,待节点响应成功后,再发送 TimeoutNowRPC
可以看出,在 etcd 中,leader 除了重置 electionElapsed 外,不会改动自己的状态。 既不会停止对客户端的响应,同时还会继续发送心跳。
因为 target 机器会更新自己的 term,而且率先发起投票,其有很大的概率赢得选举。 需要注意的是,target 发起的 RequestVoteRPC 中的 isLeaderTransfer=true, 以防止被其他节点忽略。
如果 target 机器没能在一次 electionTimeout 内完成选举,那么 leader 认为本次禅让失败(避免永久停顿在日志交接、选举等待之间,因为这样target就算选举也得不到更多票数), 立刻恢复响应客户端的请求。(这时可以再次重新发起一次禅让请求)
在 etcd/raft 中,RequestVoteRPC.context 会被设置为 campaignTransfer, 表明本次投票请求来源于 leader transfer,可以强行打断 follower 的租约发起选举。
- target 收到 leader 的
TimeoutNow后,会立即成为 candidate 并发起一轮正常的 RequestVote 选举; - 这轮选举的
RequestVote.Context = campaignTransfer; - 该标记让接收方知道:这是一次 leader 禅让,不要因为“刚收到旧 leader 心跳、自己的 election timeout 尚未到期”而忽略这张投票请求。
区别如下:
普通 follower 超时 → candidate → RequestVote
leader transfer → TimeoutNow → target 立刻 candidate → RequestVote(campaignTransfer)
| 情况 | 结果 |
|---|---|
F 与 target 都在 term + 1 选举 |
可能分票。已经投给 F 的节点不能改投 target;campaignTransfer 没有强制夺票能力。若 target 拿到多数则禅让成功,否则本轮失败,之后靠禅让超时重试选举。 |
| 节点尚未投票且刚收到旧 leader 心跳 | 由于刚收到心跳,节点通常会忽略 F 的普通投票请求;但会接受 target 带 campaignTransfer 的请求(前提是 target 日志足够新)。因此 target 有优势,但不是绝对优先级。 |
F 的 term 更高 |
更高 term 优先。target 会退回 follower 或放弃当前竞选;原 leader 的禅让流程也会结束。 |
| target 自己已经是 candidate | TimeoutNow 不会创造一轮“更高优先级”的第二次选举;它会继续已有竞选、失败后重试,或因收到更高 term 消息退回 follower。原 leader 最终会因超时取消禅让。 |
预投票问题
一个暂时脱离集群网络的节点,在重新加入集群后会干扰到集群的运行。
因为当一个节点和集群失去联系后,在等待 electionTimeout 后,它就会增加自己的 term 并发起选举, 因为联系不上其他节点,所以在 electionTimeout 后,它会继续增加自己的 term 并继续发起选举。
一段时间以后,它的 term 就会显著的高于原集群的 term。如果此后该节点重新和集群恢复了联络, 它的高 term 会导致 leader 立刻退位,并重新举行选举。
为了避免这一情形,引入了 Pre-Vote 的机制。在该机制下,一个 candidate 必须在获得了多数赞同的情形下, 才会增加自己的 term。一个节点在满足下述条件时,才会赞同一个 candidate:
- 该 candidate 的日志足够新;
- 当前节点已经和 leader 失联(electionTimeout)。
也就是说,candidate 会先发起一轮 Pre-Vote,获得多数同意后,更新自己的 term, 再发起一轮 RequestVoteRPC。
这种情形下,脱离集群的节点,只会不断的发起 Pre-Vote,而不会更新自己的 term。
在 etcd 的实现中,如果某个节点赞同了某个 candidate, 是不需要更新自己的状态的,它依然可以赞同其他 candidate。 而且,即使收到的 PreVote 的 term 大于自己,也不会更新自己的 term。 也就是说,PreVote 不会改变其他节点的任何状态。
etcd 中还有一个设计是,当发起 PreVote 的时候,针对的是下一轮的 term, 所以会向所有的节点发送一个 term+1 的 PreVoteReq。
配置变更问题
配置变更就是改变 Raft 集群中谁有投票权、谁能当 leader、提交一条日志需要谁确认。它不是普通业务配置,也不等同于“启动了一台新机器”。
常见实际场景:
- 一台机器磁盘损坏、硬件下线,需要替换成员;
- 扩容提高容错能力,例如从 3 个投票节点扩到 5 个;
- 缩容节省资源;
- 迁移机房、换 IP/节点地址、淘汰旧版本节点;
- 节点长期故障,确认无法恢复后从成员列表移除。
raft 的配置变更一般分为两种方式:一次变更一个和一次变更多个,前者可以参考该 博客,改动多个节点的配置变更可以被分成多个一次变更一个来执行;后者相对复杂,并且在某些场景下可用性更强,具体可参考 TiDB 5.0 的 介绍。
以下仅会简单介绍两种成员变更方式,具体可以参考 raft 作者博士论文的 第四章 和 Raft 成员变更的工程实践。
一次变更一台
因为在 Raft 算法中,集群中每一个节点都存有整个集群的信息,而集群的成员有可能会发生变更(节点增删、替换节点等)。 一次变更一台的情况下,Raft 要求配置变更串行化,因此限制一次性只能增/删一个节点,在一次变更结束后,才能继续进行下一次变更。
如果一次性只变更一个节点,那么只需要简单的要求“在新/旧集群中,都必须取得多数票数$⌊N/2⌋ + 1$, 那么这两个多数中必然会出现交集,这样就可以保证不会因为配置不一致而导致脑裂。
配置变更不要求重新选举 leader。原 leader 通常继续负责联合配置 C_old,new。在联合阶段,任何日志提交和新的 leader 选举都必须分别获得 C_old 与 C_new 的多数派确认。若原 leader 保持可用,它可以直接继续完成最终配置 C_new 的提交;只有发生故障或失联时,需要由满足双多数派条件的 candidate 当选。

当 leader 收到集群变更的请求后,就会生成一个特殊的 entry 项用来保存配置, 在将配置项添加到 log 后,该配置立刻生效(也就是说任何节点在收到新配置后,就立刻启用新配置)。 然后 leader 将该 entry 扩散至多数节点,成功后则提交该 entry。 一旦一个新配置项被 committed,则视为该次变更已结束,可以继续处理下一次变更了。
为了保证可用性,需要新增一项规则,节点在响应 RPC 时,不考虑来源节点是否在自己的配置文件之中。 也就是说,即使收到了一个并不在自己配置文件之中的节点发来的 RPC, 也需要正常处理和响应,包括 AppendEntriesRPC 和 RequestVoteRPC。
一次变更多台
这种变更方式可以一次性变更多个节点(arbitrary configuration)。
当集群成员在变更时,为了保证服务的可用性(不发生中断),以及避免因为节点变更导致的一致性问题, Raft 提出了两阶段变更,当接收到新的配置文件后,集群会首先进入 joint consensus 状态, 待新的配置文件提交成功后,再回到普通状态。
更具体的,joint consensus 指的是包含新/旧配置文件全部节点的中间状态:
- entries 会被复制到新/旧配置文件中的所有节点;
- 新/旧配置文件中的任何一个节点都有可能被选为 leader;
- 共识(选举或提交)需要同时在新/旧配置文件中分别获取多数同意(
separate majorities)
(注:separate majorities的意思是需要新/旧集群中的多数都同意。比如如果是从 3 节点切换为全新的 9 节点, 那么要求旧配置中的 2 个节点,和新配置中的 5 个节点都同意,才被认为达成了一次共识)
所以,在一次配置变更中,一共有三个状态:
C_old:使用旧的配置文件;C_old,new:同时使用新旧配置文件,也就是新/旧节点的并集;C_new:使用新的配置文件。
配置文件使用特殊的 entries 进行存储,一个节点一旦获取到新的配置文件, 即使该配置 entry 并没有 committed,也会立刻使用该配置。 所以一次完整的配置变更可以表示为下图:

- C_old,new 被创建,集群进入 joint consensus,leader 开始传播该 entry;
- C_old,new 被 committed,也就是说此时多数节点都拥有了 C_old,new,此后 C_old 已经不再可能被选为 leader;
- leader 创建并传播 C_new;
- C_new 被提交,此后不在 C_new 内的节点不允许被选为 leader,如有 leader 不在 C_new 则自行退位。
注意事项
不在 C_new 的节点可能会干扰集群。
当 C_new 开始生效后,被移除的节点就会收不到 heartbeat,所以在 electionTimeout 后, 这些节点会更新自己的 term 然后开始尝试竞选。若它仍能向新集群成员发送投票请求,这会导致目前的 leader 被迫退回 follower 并启动一轮投票。 这会反复发生,严重影响效率。
解决办法是,每一个 follower 增加一个机制,当节点处于 minimum election timeout 之内时, 也就是当一个节点认为自己的 leader 依然存活时,将会拒绝 RequestVoteRPC,既不会同意投票, 也不会根据 RequestVoteRPC 更新自己的 term。
但如果此时集群正好处于选举之中,那么 C_old 集群的节点可能还是会造成干扰, 因此需要结合 PreVote ,再发生electionTimeout时,只有满足多数同意才会进入cadidate增加 term,并发送RequestVote, 从而不会影响leader的退化。
这一机制会干扰到 leader transfer(禅让) 机制,因此在 leader transfer 中,RequestVoteRPC.context 会被设置为 campaignTransfer, 带有此标志位的 RequestVoteRPC 会打断targte节点,要求立刻开始进行选举。
客户端交互
虽然说 raft 算法只是一个用来构建复制状态机(Replicated State Machine, RSM)的共识协议,其只需要保证不同节点上的日志相同即可,其他的事情它都不需要关心。但是要想保证线性一致性语义,对于基于 raft 的 KV 往往还需要额外做一些事情,比如即使客户端会超时重试,也要保证日志的 exactly-once 执行。

考虑这样一个通信失败的场景,客户端向服务端提交了一条日志,服务端将其在 raft 组中进行了同步并成功 commit,接着在 apply 后返回给客户端执行结果。然而不幸的是,该 rpc 在传输中发生了丢失,客户端并没有收到写入成功的回复。因此,客户端只能进行重试直到明确地写入成功或失败为止,这就可能会导致相同地命令被执行多次,从而违背线性一致性。
对于这个问题,raft 作者介绍了想要实现线性化语义,就需要保证日志仅被执行一次,即它可以被 commit 多次,但一定只能 apply 一次。其解决方案原文如下:
The solution is for clients to assign unique serial numbers to every command. Then, the state machine tracks the latest serial number processed for each client, along with the associated response. If it receives a command whose serial number has already been executed, it responds immediately without re-executing the request.
基本思路便是:
- 每个 client 都需要一个唯一的标识符,它的每个不同命令需要有一个顺序递增的
commandId,clientId和这个commandId,clientId可以唯一确定一个不同的命令,从而使得各个 raft 节点可以记录保存各命令是否已应用以及应用以后的结果。
为什么要记录应用的结果?因为通过这种方式同一个命令的多次 apply 最终只会实际应用到状态机上一次,之后相同命令 apply 的时候实际上是不应用到状态机上的而是直接返回的,那么这时候应该返回什么呢?直接返回成功吗?不行,如果第一次应用时状态机报了什么例如 key not exist 等业务上的错而没有被记录,之后就很难捕捉到这个执行结果了,所以也需要将应用结果保存下来。
如果默认一个客户端只能串行执行请求的话,服务端这边只需要记录一个 map,其 key 是 clientId,其 value 是该 clientId 执行的最后一条日志的 commandId 和状态机的输出即可。
raft 论文中还考虑了对这个 map 进行一定大小的限制,防止其无线增长。这就带来了两个问题:
- 集群间的不同节点如何就某个 clientId 过期达成共识。
- 不小心驱逐了活跃的 clientId 怎么办,其之后不论是新建一个 clientId 还是复用之前的 clientId 都可能导致命令的重执行。
这些问题在工程实现上都较为麻烦。比如后者如果业务上是事务那直接 abort 就行,但如果不是事务就很难办了。
感兴趣可以参照 raft 博士论文第六章-客户端交互 和 dragonboat 作者在知乎上对其的 讨论。
Raft 节点对外接口
所有节点间仅通过三种类型的 RPC 进行通信:
AppendEntriesRPC:最常用的,leader 向 follower 发送心跳或同步日志。RequestVoteRPC:选举时,candidate 发起的竞选请求。InstallsnapshotRPC:用于 leader 下发 snapshot。
在 Diego 后续的博士论文中,又增加了一些 RPCs:
AddServerRPC:添加单台节点。RemoveServerRPC:移除一个节点。TimeoutNowRPC:立刻发起竞选。
(实际上 etcd 的实现中定义了几十种消息类型,甚至把内部事件也封装为消息一并处理。)
AppendEntriesRPC
参数:
term:leader 当前的 term;leaderId:leader 的 节点 id,让 follower 可以重定向客户端的连接;prevLogIndex:前一块 entry 的 index;prevlogterm:前一块 entry 的 term;entries[]:给 follower 发送的 entry,可以一次发送多个,heartbeat 时该项可缺省;leaderCommit:leader 当前的committed index,follower 收到后可用于自己的状态机。
返回:
term:响应者自己的 term;success:bool,是否接受请求。
该请求通过 leaderCommit 通知 follower 提交相应的 entries 到。通过 entries[] 复制 leader 的日志到所有的 follower。
实现细节:
- 如果
term < currentTerm,立刻返回 false - 如果 prevLogIndex 不匹配,返回 false
- 如果自己有块 entry 和新的 entry 不匹配(在相同的 index 上有不同的 term), 删除自己的那一块以及之后的所有 entry;
- 把新的 entries 添加到自己的 log;
5 。如果leaderCommit > commitindex,将 commitIndex 设置为min(leaderCommit, last index), 并且提交相应的 entries。
RequestVoteRPC
参数:
term:candidate 当前的 term;candidateId:candidate 的节点 idlastlogindex:candidate 最后一个 entry 的 index;lastlogterm:candidate 最后一个 entry 的 term。isleaderTransfer:用于表明该请求来自于禅让,无需等待 electionTimeout,必须立刻响应。isPreVote:用来表明当前是 PreVote 还是真实投票
返回:
term:响应者当前的 term;voteGranted:bool,是否同意投票。
实现细节:
- 如果
term < currentTerm,返回 false; - 如果 votedFor 为空或者为该
candidated id,且日志项不落后于自己,则同意投票。
InstallsnapshotRPC
参数:
term:leader 的 termleaderId:leader 的 节点 idlastIncludedindex:snapshot 中最后一块 entry 的 index;lastIncludedterm:snapshot 中最后一块 entry 的 term;offset:该份 chunk 的 offset;data[]:二进制数据;done:是否是最后一块 chunk
返回:
term:follower 当前的 term
实现细节:
- 如果
term < currentTerm就立即回复 - 如果是第一个分块(offset 为 0)就创建一个新的快照
- 在指定偏移量写入数据
- 如果 done 是 false,则继续等待更多的数据
- 保存快照文件,丢弃索引值小于快照的日志
- 如果现存的日志拥有相同的最后任期号和索引值,则后面的数据继续保持
- 丢弃整个日志
- 使用快照重置状态机
AddServerRPC
参数:
newServer:新节点地址
返回:
status:bool,是否添加成功;leaderHint:当前 leader 的信息。
实现细节:
- 如果节点不是 leader,返回 NOT_LEADER;
- 如果没有在 electionTimeout 内处理,则返回 TIMEOUT;
- 等待上一次配置变更完成后,再处理当前变更;
- 将新的配置项加入 log,然后发起多数共识,通过后再提交;
- 返回 OK。
RemoveServerRPC
参数:
oldServer:要删除的节点的地址
返回:
status:bool,是否删除成功;leaderHint:当前 leader 的信息。
实现细节:
- 如果节点不是 leader,返回 NOT_LEADER;
- 等待上一次配置变更完成后,再处理当前变更;
- 将新的配置项加入 log,然后发起多数共识,通过后再提交;
- 返回 OK。
TimeoutNowRPC
由 leader 发起,告知 target 节点立刻发起竞选,无视 electionTimeout。主要用于禅让。
一致性模型
一致性问题是分布式领域最为基础也是最重要的问题,具体可以参考此博客: 浅析强弱一致性。
一般来讲,分布式系统中的一致性按照对一致性要求的不同,主要分为强一致性,弱一致性这两大类,前者是基于 safety 的概念,后者是基于 liveness 的概念。
强一致性
强一致性包含线性一致性和顺序一致性,其中前者对 safety 的约束更强,也是分布式系统中能保证的最好的一致性。线性一致性更加保证顺序约束。
顺序一致性
如果一个并发执行过程所包含的所有读写操作能够重排成一个全局线性有序的序列,并且这个序列满足以下两个条件,那么这个并发执行过程就是满足顺序一致性的:
- 条件 I:重排后的序列中每一个读操作返回的值,必须等于前面对同一个数据对象的最近一次写操作所写入的值。(读取等于最近写入)
- 条件 II:原来每个进程中各个操作的执行先后顺序,在这个重排后的序列中必须保持一致。(执行顺序一致)
线性一致性
线性一致性的定义,与顺序一致性非常相似,也是试图把所有读写操作重排成一个全局线性有序的序列,但除了满足前面的条件 I 和条件 II 之外,还要同时满足一个条件:
- 条件 III:不同进程的操作,如果在时间上不重叠,那么它们的执行先后顺序,在这个重排后的序列中必须保持一致。(多进程,时间不重叠,那么执行先后顺序与重排顺序一致)
区别
- 它们都试图让系统“表现得像只有一个副本”一样。
- 它们都保证了程序执行顺序不会被打乱。体现在条件 II 对于进程内各个操作的排序保持上。
- 线性一致性 $\subseteq$ 顺序一致性
- 线性一致性考虑了时间先后顺序,而顺序一致性没有。
- 满足线性一致性的执行过程,肯定都满足顺序一致性;反之不一定。
- 线性一致性隐含了时效性保证(recency guarantee)。它保证我们总是能读到数据最新的值。
- 在顺序一致性中,我们有可能读到旧版本的数据。
弱一致性
弱一致性是指系统在数据成功写入之后,不承诺立即可以读到最新写入的值,也不会具体承诺多久读到,但是会尽可能保证在某个时间级别之后,可以让数据达到一致性状态。
可以根据能够恢复一致的时间将弱一致性进一步分类,如果是有限时间那就是最终一致性,如果是无限时间那实际上相当于没有一致性。对于前者,可以进一步分类,如下图所示:

最终一致性的分类
在实际工程实践中,最终一致性常被分为 5 种:
因果一致性(Causal consistency)
如果节点 A 在更新完某个数据后通知了节点 B,那么节点 B 之后对该数据的访问和修改都是基于 A 更新后的值。与此同时,和节点 A 无因果关系的节点 C 的数据访问则没有这样的限制。
读己之所见(Read your writes)
节点 A 更新一个数据后,它自身总是能访问到自身更新过的最新值,而不会看到旧值。其实也算一种因果一致性。
会话一致性(Session consistency)
系统能保证在同一个有效的会话中实现 “读己之所写” 的一致性,也就是说,执行更新操作之后,客户端能够在同一个会话中始终读取到该数据项的最新值。
单调读一致性(Monotonic read consistency)
如果一个节点从系统中读取出一个数据项的某个值后,那么系统对于该节点后续的任何数据访问都不应该返回更旧的值。
单调写一致性(Monotonic write consistency)
一个系统要能够保证来自同一个节点的写操作被顺序的执行。
在实际的实践中,这 5 种系统往往会结合使用,以构建一个具有最终一致性的分布式系统。

事实上,最终一致性 并不是只有那些大型分布式系统才设计的特性,许多现代的关系型数据库都采用了最终一致性模型。在现代关系型数据库中,大多都会采用同步和异步方式来实现主备数据复制技术。在同步方式中,数据的复制通常是更新事务的一部分,因此在事务完成后,主备数据库的数据就会达到一致。而在异步方式中,备库的更新往往存在延时,这取决于日志在主备数据库之间传输的时间长短,如果传输时间过长或者甚至在日志传输过程中出现异常导致无法及时将事务应用到备库上,那么很显然,从备库中读取的的数据将是旧的,因此就出现了不一致的情况。当然,无论是采用多次重试还是将数据修正,关系型数据库还是能够保证最终数据达到一致——这就是关系数据库提供最终一致性保证的经典案例。
一致性与共识的区别
一致性往往指分布式系统中多个副本对外呈现的数据的状态。如前面提到的顺序一致性、线性一致性,描述了多个节点对数据状态的维护能力。
共识性则描述了分布式系统中多个节点之间,彼此对某个状态达成一致结果的过程。
因此,一致性描述的是结果状态,共识则是一种手段。达成某种共识并不意味着就保障了一致性(这里的一致性指强一致性)。
共识机制,能够实现某种程度上的一致性。
实践中,要保障系统满足不同程度的一致性,核心过程往往需要通过共识算法来达成。
在故障节点间达成一致 —— Paxos
Paxos 是一种在节点可能宕机、网络可能延迟或丢包的条件下,让多数副本对某个值达成一致的共识算法。它是构建强一致复制状态机的理论基础;Multi-Paxos 将多个共识实例串成一份有序日志。
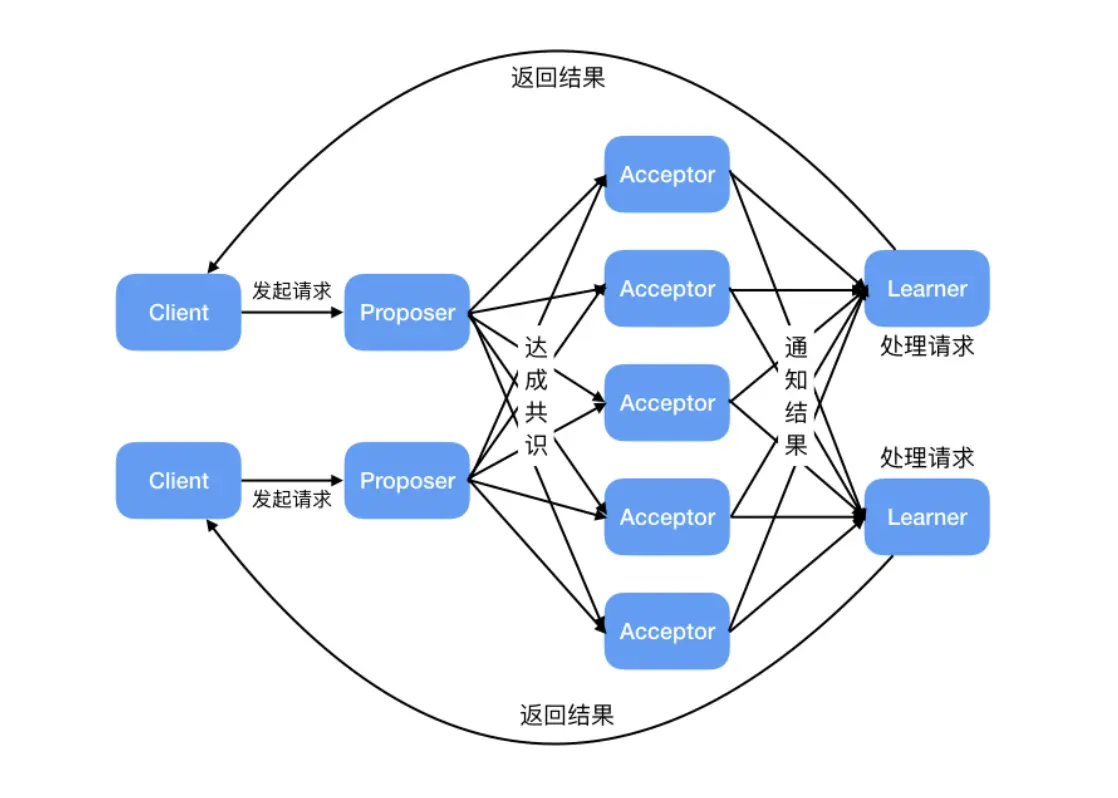
基础角色
- Proposer(提议者):提出一个值。
- Acceptor(接受者):保存投票状态并决定是否接受提案。
- Learner(学习者):获知已被选定的值并执行;角色可由同一节点兼任。
- Proposal / Ballot:提案编号
n与值v;n必须全局唯一且单调增大。
核心是“多数派”:任意两个多数集合必有至少一个交集。
Single-Decree Paxos 流程
目标:为一个槽位选定一个且仅一个值。
- 提议者选择更大的提案号
n,向多数 Acceptor 发送Prepare(n)。 - Acceptor 若尚未承诺更大的编号,就回复
Promise(n):以后不接受编号小于n的提案,并带回自己曾接受过的最大编号提案及其值(若有)。 - 提议者收到多数
Promise后:- 若回复中已有被接受过的值,必须选择其中编号最大者的值;
- 否则可以选择自己的新值。
- 提议者向多数 Acceptor 发送
Accept(n, v)。 - Acceptor 若未承诺过更大的编号,就接受
(n, v)。 - 多数 Acceptor 接受同一个
(n, v)后,v被 chosen(选定/决定);Learner 可学习该结果。
能保证什么
- 安全性(Safety):一个槽位最多只能选定一个值;不会出现两个不同值都被决定。
- 有效性(Validity):被选定的值一定来自某个提议者提出的值。
- 容错性:
N个投票节点最多可容忍⌊(N - 1) / 2⌋个宕机;例如 3 节点容忍 1 个故障。 - 强一致共识:将 Multi-Paxos 选定的日志按顺序应用到各副本,可构建强一致的复制状态机。
强一致共识
Paxos 的核心属性是强一致共识。
- 最终一致性允许副本暂时返回不同结果,之后再收敛。
- Paxos 不允许同一日志槽位最终决定两个不同值;一旦某值被多数选定,之后的提案只能延续它。
- 网络分区时,没有多数的一侧通常无法继续提交,而不是各自写入、之后再合并。
注意:Paxos 共识保证“日志决定唯一”;若要对客户端提供线性一致读写,还需把日志提交、状态机应用和读请求协议正确组合起来。
ZooKeeper 的强一致复制协议 —— ZAB
ZAB(ZooKeeper Atomic Broadcast)是 ZooKeeper 为主从复制设计的、支持崩溃恢复的原子广播协议。它不是 Paxos,但同样依赖多数派来保证一致性与容错。
ZAB 的目标是:让 ZooKeeper 集群对事务形成唯一、全局有序的提交序列;已提交事务不会在 leader 故障后丢失,新 leader 不会在缺失旧事务的情况下继续广播新事务。
集群与持久化
- 集群通常包含 Leader、Follower、Observer。
- Leader 处理和广播写事务;Follower 参与选举和写事务的多数确认;Observer 可同步数据、服务读,但不参与投票和写确认。
- ZooKeeper 的数据主要在内存中;事务先记录到 WAL,并周期性生成快照,以支持崩溃恢复。
- 有
N个投票节点时,提交或选举都需超过半数,即⌊N/2⌋ + 1;2f + 1个投票节点可容忍f个故障。节点数取奇数只是更节省机器,并非协议硬性要求。
zxid
每个写事务都有全局递增的 zxid(ZooKeeper Transaction ID)。
zxid = epoch | counter
- 高 32 位
epoch:leader 任期/世代;产生新 leader 后进入新 epoch。 - 低 32 位
counter:该 epoch 内事务序号。 - 因而
zxid可定义全局事务顺序,并帮助选举时判断谁拥有更新的日志。
注意:创建“顺序 znode”时追加在节点名后的序号,与事务 zxid 不是同一个概念。
两种运行模式
1. 恢复模式:选主并同步
leader 宕机或集群初始启动时,投票节点进入 LOOKING 状态并发起选举。
- 节点以本地选举轮次、候选节点 ID、候选节点最大
zxid发送选票。 - 候选日志更新程度优先:
zxid更大者优先;相同时再按节点 ID 等规则打破平局。 - 某候选获得多数票后成为 leader,其他节点转为 follower。
- 新 leader 与 follower 同步事务历史;达到所需多数的同步条件后,才进入广播模式。
这一步的关键不是“选出任意 leader”,而是确保新 leader 的历史能承接所有已提交事务。这样旧 leader 的已提交事务不会消失,新 leader 也不会从错误的历史分叉继续写入。
2. 广播模式:复制并提交事务
- 客户端写请求被转发给 Leader。
- Leader 为请求生成带
zxid的PROPOSAL,按顺序广播。 - Follower 将事务持久化到日志后回复确认;Observer 可接收同步,但其确认不计入多数。
- Leader 收到投票节点多数确认后,发送
COMMIT。 - 各副本按
zxid顺序应用事务;Leader 再向客户端返回成功。
所以客户端收到“写成功”时,至少一个多数派已经持久化该事务。即使随后 leader 宕机,后续选出的 leader 也必须继承它。

ZAB 保证
- 原子性:事务要么按提交序列被应用,要么不生效。
- 全局顺序:所有副本按同一
zxid顺序提交事务。 - 前缀一致性:任意两台已同步副本的已提交历史不会分叉,只可能一方比另一方落后。
- 崩溃恢复安全性:已提交事务不会因 leader 更替而丢失;新 leader 先完成历史同步,再广播新事务。
- 写的线性化:写操作经过 leader 与多数确认后形成单一提交顺序。
读与一致性边界
ZooKeeper 为读性能优化:普通读可在任一副本本地执行,因此可能读到落后的数据;这不违背它的事务广播顺序。
客户端可在读前调用 sync(),使连接的副本先追到相应同步位置,再进行读取。原网页引用的后续讨论还指出:某些实现中 sync + read 的严格线性一致性需要谨慎评估,特别是在网络分区与旧 leader 响应等边界场景。
因此应记住:
- ZAB 强一致地复制写事务顺序。
- 普通 follower 读不天然是线性一致读。
- 若业务需要严格线性一致读,必须审查具体 ZooKeeper 版本和读路径。
分布式组件
RPC
1. RPC 是什么
RPC(Remote Procedure Call,远程过程调用)是一种让程序以“调用方法”的形式请求另一台机器上服务的通信方式。调用方不必手写网络收发细节;框架负责把参数打包、发送、执行远端方法并返回结果。

RPC 屏蔽通信细节,但不会消除网络成本。 远程调用仍可能超时、失败、重复执行或返回变慢,因此必须设计超时、重试、限流、熔断和幂等性。
2. 一次 RPC 调用的五步
- 客户端调用:业务代码调用本地代理(Stub),如
userService.getUser(id)。 - 请求发送:Stub 将“服务/方法名 + 参数 + 元数据”序列化成字节,通过网络发往服务端。
- 服务端接收与处理:服务端反序列化请求,定位目标服务和方法,执行业务逻辑。
- 结果返回:服务端将返回值或异常序列化后发回。
- 客户端接收结果:客户端反序列化响应,把结果或错误交还给调用方。
题图中的核心角色是:客户端代理(Stub) 负责封装调用,服务端调度/骨架层负责解析请求并调用真实服务实现。
3. RPC 要解决的关键问题
| 问题 | 常见做法 |
|---|---|
| 如何描述接口与方法 | 用 IDL(接口定义语言)定义服务、方法、参数和返回类型,并生成多语言代码。 |
| 如何表示数据 | 序列化/反序列化,例如 Protobuf、JSON、Thrift 二进制协议。 |
| 如何传输数据 | 约定网络传输与消息格式(Wire Protocol),可基于 TCP、HTTP/2 或 HTTP。 |
| 如何找到服务 | 服务注册与发现、负载均衡、路由。 |
| 如何稳定调用 | 超时、重试、熔断、限流、鉴权、监控与链路追踪。 |
4. RPC、IPC 与 REST
- IPC:同一台机器上的进程间通信,例如管道、消息队列、共享内存和本地 Socket。
- RPC:通常面向不同机器/节点之间的方法调用;底层常借助 Socket 等网络能力。
- REST:以资源为中心,使用 URI 和
GET、POST、PUT、DELETE等 HTTP 语义;适合开放、易理解、缓存友好的 Web API。 - RPC:以“调用动作/方法”为中心,更适合服务内部的高频调用、强类型接口、多语言调用或流式通信。
RPC 可以运行在 HTTP 之上(HTTP-based RPC);“使用 HTTP”不等于“就是 REST”。
5. 常见框架如何选
| 框架 | 典型特点 | 适合场景 |
|---|---|---|
| gRPC | 默认基于 HTTP/2 与 Protobuf;跨语言、低延迟、支持流式通信。 | 多语言微服务、内部高性能调用、实时数据流。 |
| Dubbo | Java 生态成熟,服务治理与扩展能力强。 | Java 为主、需要注册发现和治理能力的微服务系统。 |
| Apache Thrift | IDL 与代码生成完善,支持多语言和多种传输/协议。 | 跨语言服务、数据平台与高效数据传输。 |
| 选择时优先看:团队语言栈、性能和延迟目标、是否需要流式调用、服务治理成熟度、可观测性,以及社区维护情况。 |
6. 记忆框架
接口定义 → 生成代理 → 序列化请求 → 网络传输 → 服务端分发执行 → 序列化响应 → 客户端还原结果
可以把 RPC 看成“带契约的远程函数调用”:IDL/接口是契约,序列化是翻译,传输协议是道路,服务治理保障道路拥堵或故障时仍能尽量稳定通行。
7. 易错点
- 不要把 RPC 当成本地函数:网络故障与延迟始终存在。
- 重试可能造成重复写入;对写操作要考虑幂等键或去重。
- 序列化格式应兼顾性能、可读性与兼容演进。
- ZeroMQ、MQTT、WebRTC 更偏消息通信或实时传输技术,不能简单等同于通用 RPC 框架;是否适用取决于通信模式。
8.组合方式
public 是 “is-a”(是一种),而 private 继承官方语义是 “is-implemented-in-terms-of”(根据某物实现)
一般下,RPC 是 public 继承。
跳表

- 定位:Redis 的
Zset在采用跳表时,底层是“跳表 + 哈希表”。跳表负责有序范围查询,哈希表支持按成员常数时间获取分数。 - 核心思想:在有序链表上建立多层索引;从最高层开始横向移动,遇到不满足条件时下沉一层,最终在底层定位元素。平均查询复杂度为
O(log N),普通链表为O(N)。 - 节点内容:元素
ele、分数score、用于逆序遍历的后向指针backward,以及level[]层级数组。每层保存:forward:同层后继节点;span:跨越的底层节点数,用于计算排名(路径上的跨度累加)。
- 跳表元信息:保存
header、tail、节点总数length和当前最大层数level,均可直接获取。 - 排序与查找:按
(score, ele)排序。当前节点分数更小,或分数相等但元素字典序更小时,继续同层向前;否则下沉一层。 - 层数随机化:理想相邻层节点数比例为
2:1,但 Redis 不强制维护;新节点以25%概率继续升高一层,层数越高概率越低。网页所述 Redis 7.0 最大层数为32。 - 为何不用平衡树:
- 指针数量可通过概率参数调节;当
p=1/4时,平均约1.33个指针/节点; - 范围查询只需定位下界后沿底层链表顺序遍历;
- 插入、删除主要调整相邻指针,实现和调试比 AVL/红黑树简单。
- 指针数量可通过概率参数调节;当
记忆一句话:跳表 = “多层有序链表 + 随机层高”,用高层快速跳跃、低层精确定位,并通过 span 支持排名。
Protobuf
Protobuf(Protocol Buffers)是一套“约定数据长什么样,并把数据高效变成字节”的工具。
它解决的问题不是“怎么把请求从 A 机器送到 B 机器”,而是“送过去的字节如何让双方都准确看懂”。因此它常与 gRPC 一起出现:gRPC 负责调用和传输,Protobuf 负责接口契约与数据编码。
它有什么功能
- 定义数据契约:在
.proto文件中写清楚有哪些字段、字段类型和编号。 - 生成多语言代码:用
protoc把这份定义生成 Java、Go、Python、C++ 等语言的类/结构体和读写方法。 - 序列化与反序列化:将内存中的对象编码为二进制字节;接收端再从字节还原对象。
- 支持协议演进:只要遵守字段编号规则,新旧版本服务可以在一段时间内互通。
例如:
1 | syntax = "proto3"; |
这份定义的意思是:任何语言的程序都把 User 理解为拥有 id、name、active 的数据;其中 1、2、3 是字段的永久身份编号。
它是怎样实现的
可以把一次跨服务传数据想成“寄包裹”:
业务对象 → Protobuf 编码 → 二进制字节 → 网络 → Protobuf 解码 → 业务对象
以 User { id: 1, name: "Li", active: true } 为例,编码后的数据大致为:
1 | 08 01 12 02 4C 69 18 01 |
不需要记住这些十六进制数,但要理解它的设计:每个字段由 字段标签 + 值 组成。
- 标签携带“这是第几个字段”和“值采用什么编码方式”。
- 整数常采用 Varint:小数字只占很少的字节。
- 字符串这类变长内容写成“长度 + 原始字节”。
- 未赋值的标量默认值通常不写入网络数据,进一步减小体积。
接收方并不依赖字段在消息中的位置,而是读标签中的字段号再决定如何解析。因此字段可以按任意顺序出现,也可以跳过不认识的字段。这正是演进能力的基础。
为什么不用直接传 JSON
JSON 当然能传数据,而且在开放 API、浏览器交互和人工排查时很方便;Protobuf 的优势在于服务间通信常见的约束:
| 需求 | JSON | Protobuf |
|---|---|---|
| 体积 | 字段名和文本数字会重复占空间 | 二进制,字段用编号表示,通常更紧凑 |
| 解析 | 文本解析、类型约束较弱 | 按 Schema 编码/解码,类型明确 |
| 多语言协作 | 靠文档约定字段 | .proto 作为单一契约并生成代码 |
| 演进 | 容易因字段约定漂移出错 | 字段编号与未知字段机制支持渐进升级 |
| 可读性 | 好 | 差,需要工具查看 |
| 所以选择 Protobuf 的核心理由通常是:高频、跨语言的内部通信,希望减少带宽和解析成本,并用一份正式契约减少接口歧义。 它不是“总是比 JSON 好”;低频、面向第三方或需要直接读懂报文的 API,JSON 往往更合适。 |
为什么字段编号不能改
字段名 name 只是给开发者看的,线上字节中真正识别字段的是编号 2。
假如旧版中 2 表示 name,新版把 2 改成 email,旧服务收到新版消息时会把邮箱误当作名称——数据虽然“能解析”,语义却错了。这类错误最危险。
因此最重要的演进规则是:
- 可以新增字段,使用从未用过的新编号。
- 不要修改已发布字段的编号,也不要把删除字段的编号分给新字段。
- 删除字段后用
reserved保留它的编号/名称,防止将来误用。
这使部署可以渐进进行:新版客户端可以发送新增字段,旧服务忽略不理解的字段;旧客户端没发送的新字段,新服务按默认值处理。
它在 RPC 中的位置
当 gRPC 调用 GetUser 时,调用流程可简化为:
1 | 客户端生成的 Stub |
Protobuf 只负责“请求和响应的格式”。网络连接、超时、重试、负载均衡、鉴权与服务发现,仍需要 gRPC 或其他 RPC/基础设施处理。
总结
.proto 是双方都签字的数据合同;protoc 是翻译器;二进制编码是更省空间的包裹;字段编号是包裹里的永久标签。
当系统跨语言、调用频繁、接口需要长期演进时,Protobuf 的价值就会非常明显。